实验日期:2026 年 10 月 22 日 主题:硬件辅助虚拟化、指令计时、实验方法与证据判读
在同一台物理宿主上,一个包含 CPUID 的测量窗口,原生执行时的中位数是 125 个 TSC 刻度,Windows/KVM 客户机中则是 2007。与此同时,128 次整数加法的窗口中位数在两侧都是 134。
这组结果有意思的地方,在于差异集中出现在 CPUID 路径:普通运算与读取时间戳的对照接近,多个 CPUID 叶却稳定增加了开销。
本文记录这次实验的设计、结果和解释。它支持一个具体结论:在本次硬件和软件配置下,CPUID 时序呈现了明显、可重复的虚拟化行为差异。 要将它发展成跨硬件、跨系统的识别规则,还需要更多验证。
一 为什么选择 CPUID
CPUID 根据输入的叶编号和子叶编号返回处理器信息。这里研究的对象是执行这一查询所需的时间,以及它与同机其他操作的相对关系。
这个选择有明确的架构背景。在本例 Intel VMX 中,正常执行的 CPUID 在 VMX non-root 模式下会导致 VM exit:处理器离开客户机执行状态,由虚拟化软件处理,再继续客户机执行。Intel 手册将 CPUID 列入无条件导致 VM exit 的指令类别;这条规则没有给出通用的耗时下限。[1]
KVM 的公开 VMX 源码把 CPUID 退出分派给内核中的 kvm_emulate_cpuid。这里的“退出”通常由宿主内核处理,不能理解成每次都要返回用户态 QEMU。[2]
这提供了一个可以检验的预期:如果这条额外处理路径在本机计时中有显著影响,CPUID 窗口应当比普通对照表现出更明显的差异。
架构说明能够解释为什么会有额外路径;具体差多少、是否稳定,仍应由测量回答。本文引用公开源码解释常规机制,没有把该快照当作已安装 PVE 内核的逐指令审计。
二 实验环境与比较对象
实验在同一套实体硬件上比较 Linux 宿主原生执行和 Windows 客户机执行。
| 项目 | 配置或记录 |
|---|---|
| 实体 CPU | Intel Xeon E5-2680 v2,标称 2.80 GHz |
| 宿主 | PVE Linux,内核 6.8.12-9-pve |
| 客户机 | Windows,QEMU/KVM,20 个逻辑处理器 |
| 已测逻辑处理器 | 两侧各选择编号 0、2、4 |
| 计时单位 | TSC 刻度 |
| 采集安排 | 首次完整采集,随后一次独立完整复测 |
客户机使用已有的自定义配置,因此结果描述的是这个实例,不能直接代表 PVE 的默认安装或全部 KVM 配置。本文也没有把用户态观察到的某个差异归因到某一项配置。
宿主与客户机的操作系统不同,这是实验设计中保留的一个重要混杂因素。来宾 vCPU 0 也不等于始终运行在宿主逻辑 CPU 0;相同编号不构成物理核心配对。
三 如何尽量让两侧测量可比
1 使用相同的探针机器码
Windows 使用本机编译的 x64 程序调用探针;Linux 使用 Python 的 ctypes 调用原生机器码。完整探针库共有 28 个探针体,两侧逐体 SHA-256 一致,其中 12 项属于本文的指令计时实验。
Linux 侧另外使用了位于单次计时窗口之外的 ABI 寄存器适配代码。每一批的 4000 个样本在原生机器码循环内采集,Python 并不参与每个样本的计时窗口。
这样可以降低探针实现不同造成的影响,但机器码相同并不会让操作系统、代码布局、后台活动和调度环境也完全相同。
2 测量的是操作窗口
每个样本在待测操作前后读取 RDTSCP,并配合其后的 LFENCE 约束边界附近的执行顺序。两端的 TSC 差值作为记录值,同时保存 TSC_AUX。
RDTSCP 并非完全序列化指令,Intel 对其前后顺序有明确说明,且列出了后置 LFENCE 的用法。这样的边界控制并不会屏蔽中断、抢占或宿主调度。[3]
计时窗口还包含时间戳保存、操作所需寄存器准备等工作。因此,下文所有数字都应理解为:
相同计时框架下,包含待测操作的窗口 TSC 差值。
它不是纯 CPUID 指令延迟,更不是单独拆分出的 VM exit 硬件成本。表中的 empty 也不是零指令窗口,其操作体实际包含一条 NOP,适合作为基线窗口。
3 加入不同类型的对照
12 项操作包括:
- 基线与普通执行:empty、32 条 NOP、128 次依赖整数加法;
- 时间戳和执行边界:RDTSC、RDTSCP、LFENCE;
- 其他查询:XGETBV(0);
- CPUID:叶 0、1、7,以及两个额外叶编号请求。
对照组回答一个关键问题:观察到的变化,是所有窗口普遍变慢,还是主要集中在特定执行路径?
4 重复采样并完整复测
每个环境、每次完整采集的样本数为:
12 项操作 × 3 个逻辑处理器 × 3 个批次 × 4000 个样本 = 432000。
因此,每项操作每次采集合并了 36000 个样本;两种环境各进行两次完整采集,共计 1728000 个指令计时样本。本文的汇总中位数是对相应原始样本合并后计算的结果,不是各批次中位数的平均值。
分析程序按两端 TSC_AUX 是否相同检查样本,本次实际因这一规则排除的样本为 0;没有按结果是否符合预期删除慢样本。
TSC_AUX 相同只说明两个端点返回了相同的辅助值,不能排除期间发生抢占,也不能证明客户机背后的宿主物理 CPU 始终不变。
四 中位数显示了明显的路径差异
下表为完整计时窗口的中位数。单位是 TSC 刻度;倍数为客户机中位数除以宿主中位数。
| 操作 | 宿主首次 | 客户机首次 | 首次倍数 | 宿主复测 | 客户机复测 |
|---|---|---|---|---|---|
| empty | 46 | 50 | 1.09× | 47 | 50 |
| nop32 | 53 | 56 | 1.06× | 53 | 56 |
| add128 | 134 | 134 | 1.00× | 134 | 136 |
| rdtsc | 68 | 70 | 1.03× | 68 | 71 |
| rdtscp | 74 | 77 | 1.04× | 72 | 77 |
| lfence | 53 | 59 | 1.11× | 53 | 56 |
| cpuid0 | 125 | 2007 | 16.06× | 125 | 2009 |
| cpuid1 | 339 | 2009 | 5.93× | 339 | 2013 |
| cpuid7 | 246 | 2237 | 9.09× | 246 | 2243 |
| cpuid_hv | 252 | 2184 | 8.67× | 252 | 2184 |
| cpuid_invalid | 252 | 2147 | 8.52× | 252 | 2192 |
| xgetbv0 | 49 | 53 | 1.08× | 49 | 50 |
cpuid_hv 和 cpuid_invalid 是探针名称,分别对应叶 0x40000000 和 0x13371337 的请求。名称只描述请求值,不表示实验发现了有效的 hypervisor 厂商信息;超范围叶返回非零数据本身也不能作此推断。
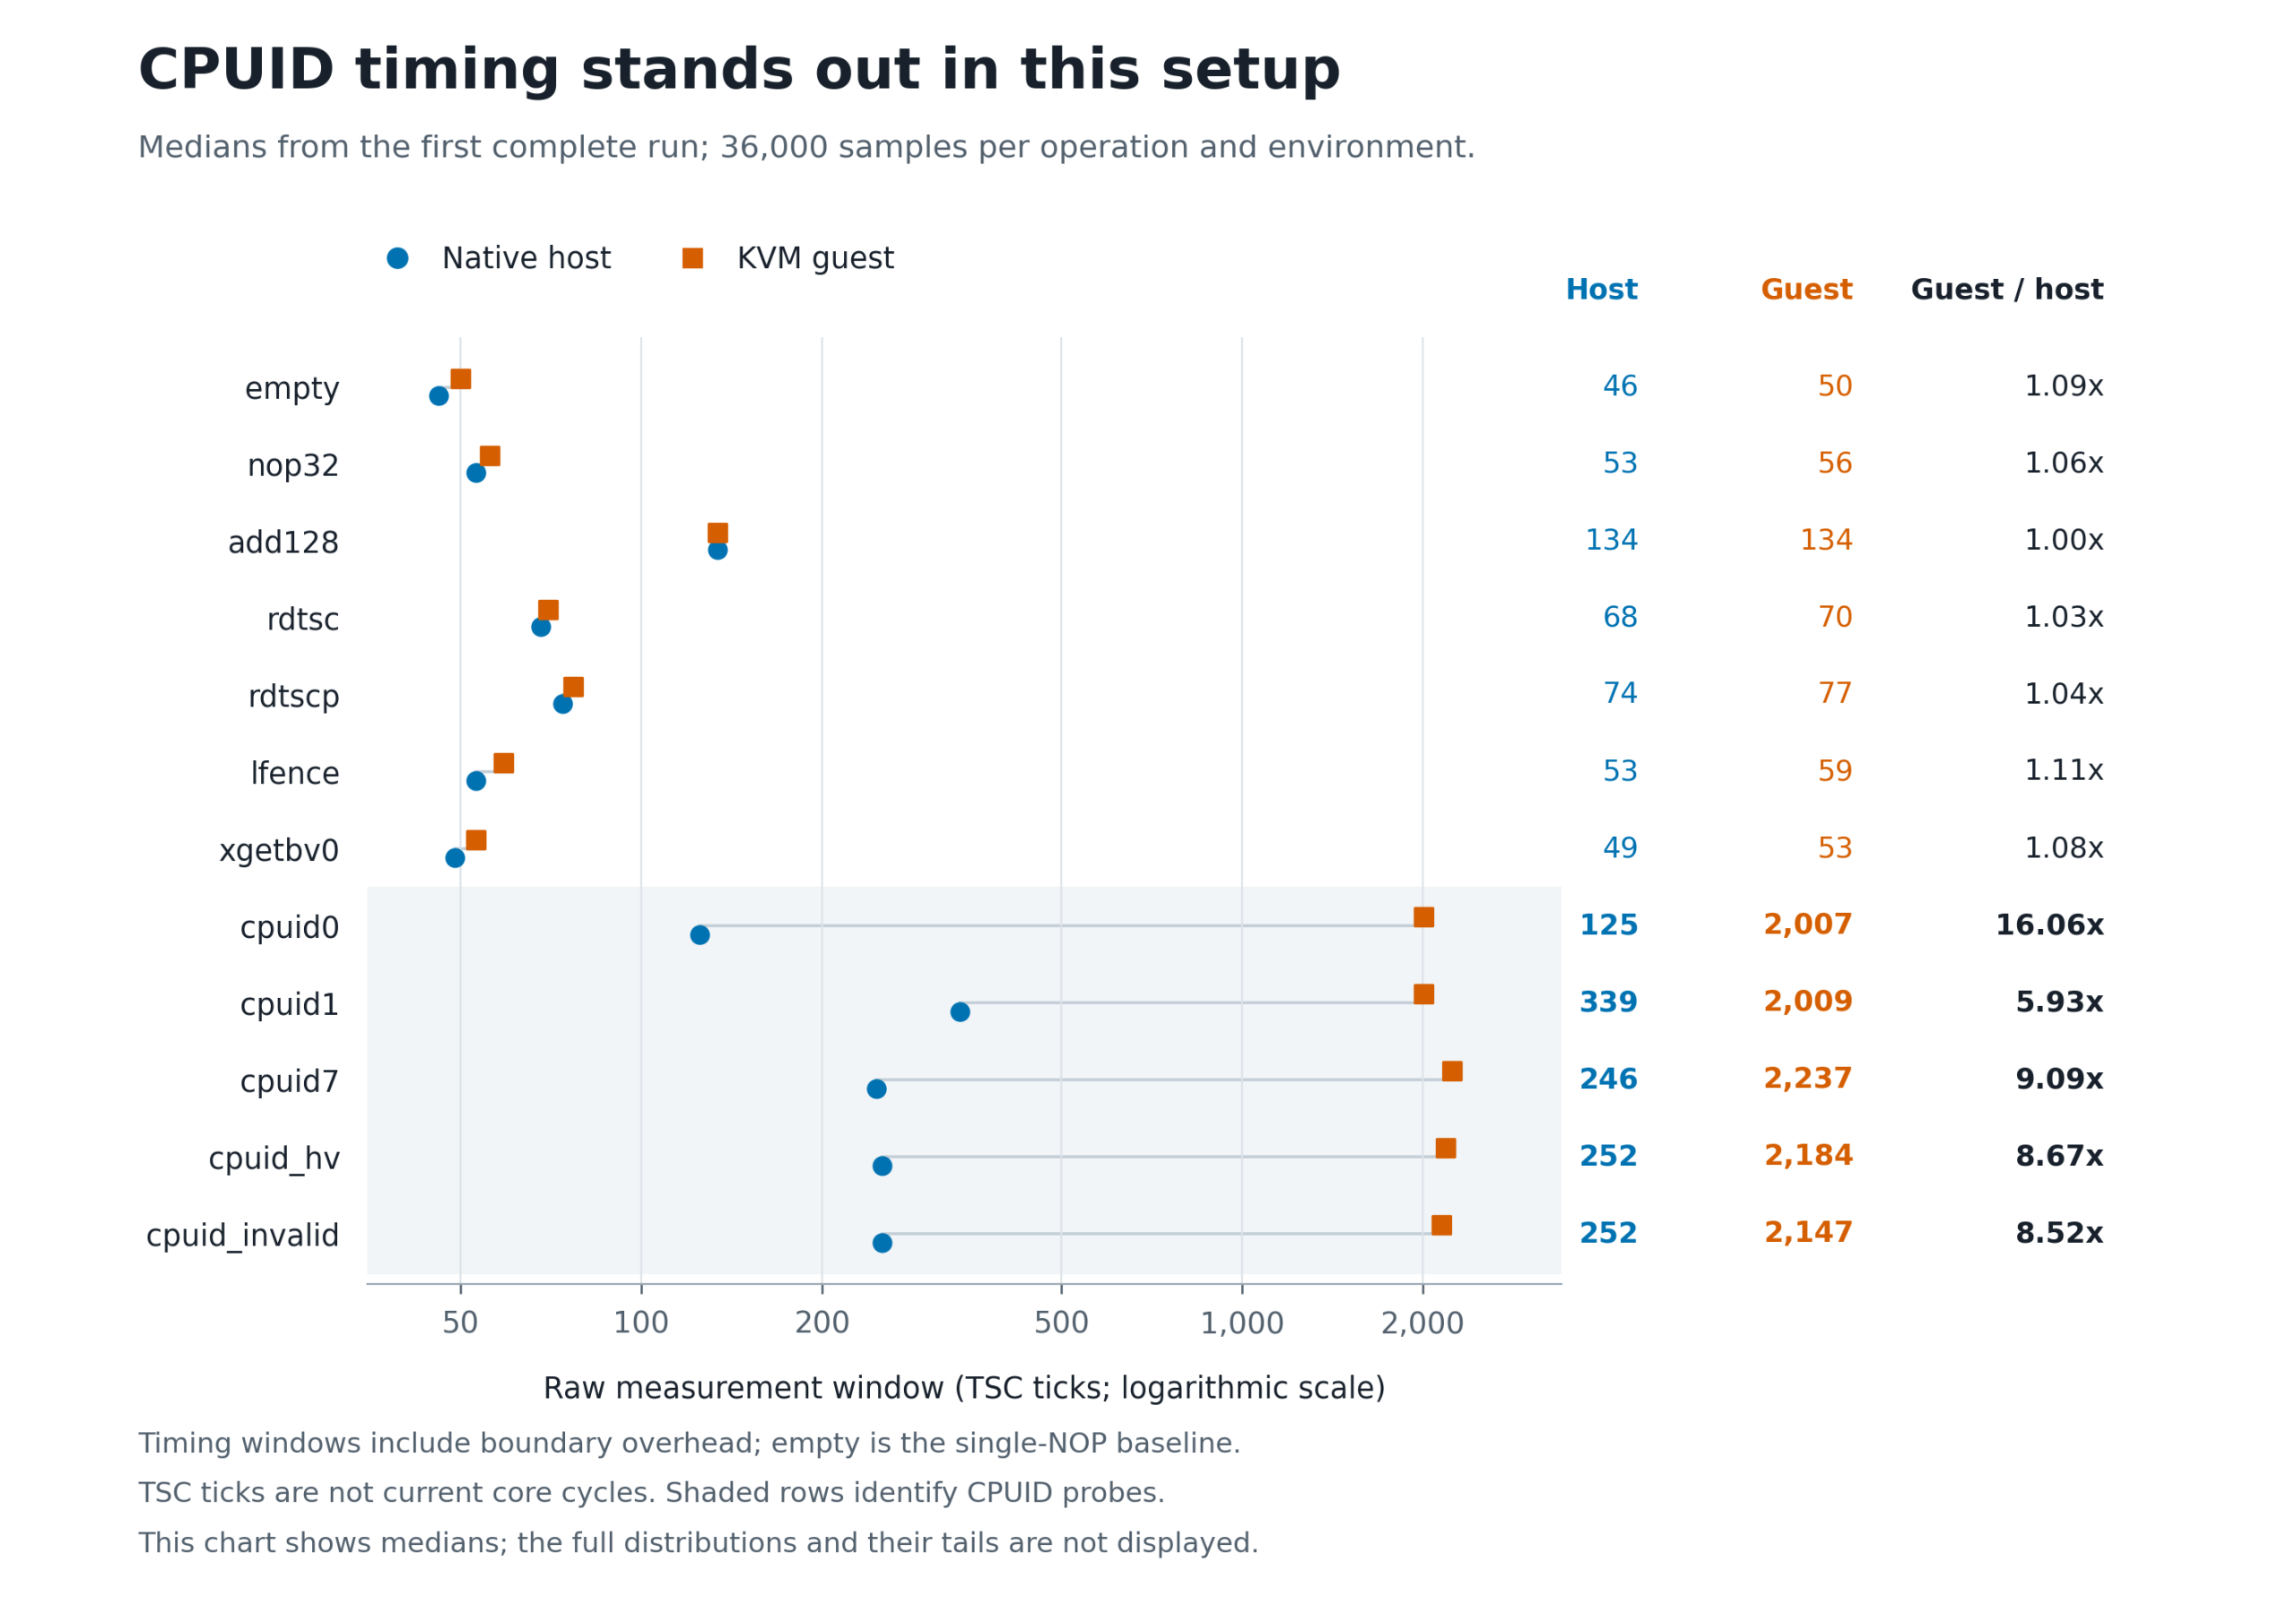
图 1:蓝色圆点为宿主原生执行,橙色方点为客户机。横轴使用对数坐标;每项、每个环境汇总 36000 个样本。阴影标出 CPUID 操作,右侧列出中位数和比值。图中展示的是中位数,不是完整分布。数据:随文聚合表。
普通对照接近
首轮中,add128 的两侧中位数相同。RDTSC 从 68 到 70,RDTSCP 从 74 到 77,基线从 46 到 50。
这些对照有助于解释结果:本次观察并不表现为所有操作都增加同样数量级的开销。
多个 CPUID 叶一致出现额外耗时
首轮五类 CPUID 窗口的客户机/宿主中位数比值约为 5.93–16.06;七类对照操作约为 1.00–1.11。
其中,宿主上的 cpuid0、cpuid1、cpuid7 分别为 125、339、246,说明不同叶在原生执行时本来就没有一个统一的固定耗时。客户机中的这些窗口则集中在约 2000–2200 刻度,并且仍有叶之间的差别。
这组数据与“CPUID 经过额外的虚拟化退出处理路径”的架构解释相符。不过,实验没有逐段测量硬件退出、KVM 处理和重新进入客户机的成本,不能把整个差值都命名为纯 VM exit 延迟。
独立复测保留了主要差异
客户机 cpuid0 的中位数从 2007 变为 2009,cpuid1 从 2009 变为 2013,cpuid7 从 2237 变为 2243。宿主这三个中位数在复测中没有变化。
各个已测逻辑处理器上也保留了明显差异,但数值并非处处相同。例如,客户机复测的 cpuid1,在逻辑处理器 0、2、4 上的中位数分别为 2013、2007、2116。
更准确的表述是:差异在已测处理器位置和独立复测中保持存在,局部数值仍会波动。
五 中心分布分离,不等于全部样本可分
只比较中位数容易漏掉一个事实:原生执行也可能出现非常慢的样本。
先看首轮 CPUID 0、1、7 的中心区间:
| 操作 | 宿主 P05 / 中位数 / P95 | 客户机 P05 / 中位数 / P95 |
|---|---|---|
| cpuid0 | 121 / 125 / 135 | 1994 / 2007 / 2243 |
| cpuid1 | 333 / 339 / 369 | 1995 / 2009 / 2116 |
| cpuid7 | 242 / 246 / 262 | 2196 / 2237 / 2573 |
每个单元格对应 36000 个样本。这里的 P05–P95 表示样本中心约 90% 的范围,不是中位数或均值的置信区间。
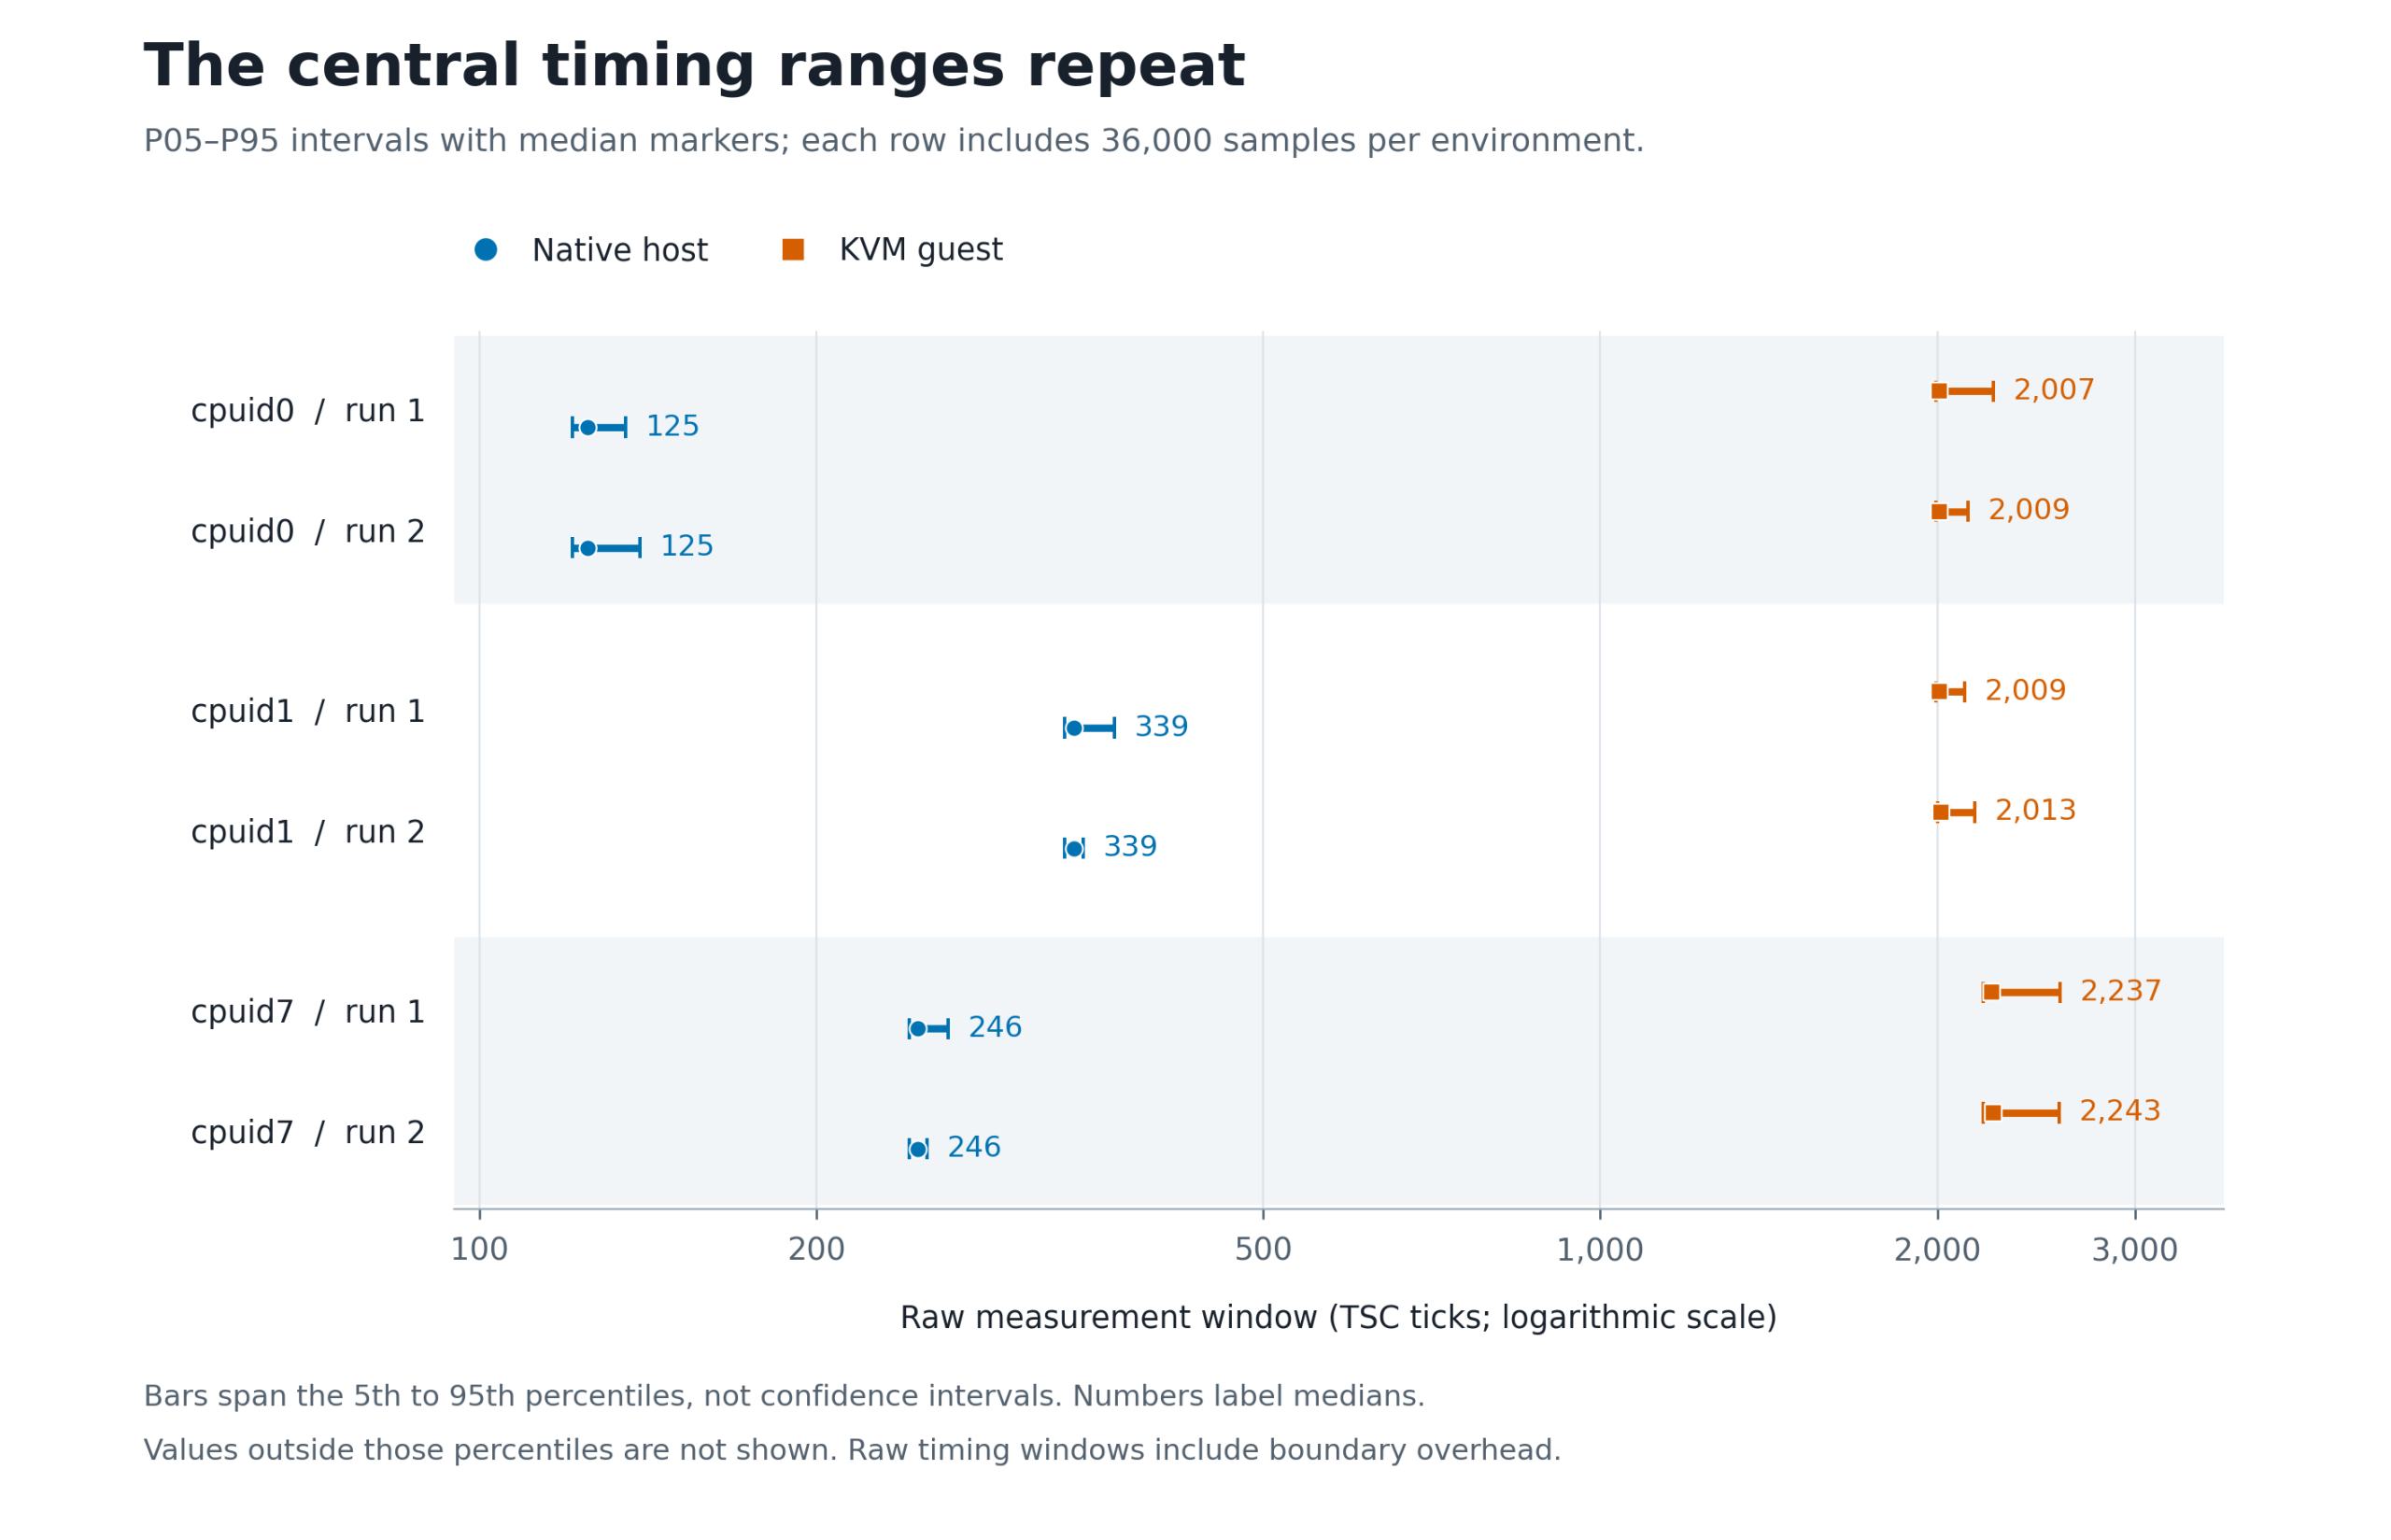
图 2:CPUID 0、1、7 在首次采集及完整复测中的 P05–P95 区间与中位数。每行、每个环境有 36000 个样本;横轴为对数坐标。分位区间之外的观测值和长尾没有画出,未从原始数据中删除。
可以看到,两侧中心分布相距很远,复测后仍然如此。但首轮宿主 cpuid0 的最大值达到 35153,远高于其 125 的中位数。
这类长尾提醒我们,指令计时会受到运行环境影响。本次记录没有逐个归因慢样本,因此不能把每个长尾都解释为某一种中断、抢占或硬件事件。
用一个阈值例子看清区别
仅为描述这份数据,假设检查“窗口是否达到或超过 1000 个 TSC 刻度”。五类 CPUID 的样本计数如下:
| 环境 | 首次采集达到阈值的样本 | 复测达到阈值的样本 |
|---|---|---|
| 宿主原生执行 | 58 / 180000 | 55 / 180000 |
| 客户机 | 180000 / 180000 | 180000 / 180000 |
这个阈值很好地分开了本次记录的中心区域,但仍会把少量宿主慢样本置于阈值之上。
这里统计的是样本越线计数,不是跨机器的分类准确率或误报率。阈值是在已见数据上作描述性示例,也没有经过独立硬件测试集验证。不能据此宣称已经获得了一个“99.97% 准确”的通用虚拟机检测器。
六 TSC 刻度应当怎样解读
TSC 是时间戳计数器。它的刻度不能直接等同于 CPU 当前核心周期;采用恒定速率 TSC 时,计数频率与瞬时核心频率不是同一个量。因此本文统一使用“TSC 刻度”,不将 2007 刻度写成“当前 CPU 执行了 2007 个核心周期”。[4]
本次还将 TSC 增量与系统单调计时的时间差进行比较,得到如下频率估计:
| 环境 | 首次估计 | 复测估计 |
|---|---|---|
| 宿主 | 2.793587 GHz | 2.793596 GHz |
| 客户机 | 2.793354 GHz | 2.793344 GHz |
这些读数接近,但校准结果不能替代时间来源分析。宿主记录的 clocksource 为 HPET;Windows QPC 的接口频率是 10 MHz,其底层来源没有独立确认。
QPC 可能基于 TSC,所以两个接口读数相符,未必构成两套独立物理时钟的交叉验证;单凭 10 MHz 也不能认定底层就是某种平台计时器。[4]
另一个常见误用是,用 CPUID 窗口中位数减去基线中位数,并把结果称为精确的单指令或退出成本。基线对照有分析价值,但指令之间的顺序约束和执行交互并不保证严格可加;两个中位数之差也不等于某个内部阶段被直接测量。因此本文保留原始窗口值作为主结果。
七 它作为检测证据有多强
就本次实例而言,CPUID 时序是一项容易在实验中获得、区分度强、能够重复观察到的行为证据。
支持这个判断的依据有三点:
- 多个 CPUID 叶的中心分布都出现明显偏移。
- 普通整数与读取时间戳的对照接近,使“所有窗口普遍同幅变慢”的解释不符合这组观察。
- 差异在多个已测逻辑处理器和完整复测中保留。
其中最有价值的信息,是各类操作之间的关系。单独看到一次 2000 刻度的读数,解释空间很大;结合相同环境中的普通对照、多个 CPUID 叶和重复采样,证据会更充分。
但从“有明显虚拟化行为差异”到“准确判断任意终端的环境”,仍然有几步不能省略。
1 单台机器无法覆盖处理器与系统差异
两侧两次采集的样本总数超过 170 万,但这些样本来自同一套宿主硬件和一个客户机配置。
大量重复采样提高了对当前环境的认识,不等于增加了同样数量的独立机器。相邻采样、同核批次和同机复测之间也存在相关性,不能直接据此估计大规模用户环境的误报率。
2 观察到 hypervisor 相关影响,不足以识别具体平台
实体 PC 上直接安装的 Windows,也可能因 VBS 使用 Windows hypervisor。微软的官方说明明确指出,VBS 使用硬件虚拟化功能和 Windows hypervisor 建立隔离环境。[5]
因此,计时结果需要结合被研究的环境类别解释。本实验没有建立不同 VBS 状态、不同 hypervisor 和不同硬件之间的对照,不能仅凭 CPUID 时序将其全部区分。
3 实验结果不揭示具体产品的检测逻辑
这份数据证明了一个可以测量的现象,并没有证明某款商业软件采用了相同特征、阈值或判定方式。
同样,应用程序的退出或兼容性问题,需要对应的日志与因果验证。不能从“机器存在明显时序差异”,直接跳到“某次程序退出就是这项检测触发的”。
八 实验的主要局限
操作系统不同。 Linux 宿主与 Windows 客户机不是只改变虚拟化状态的严格单变量实验。相同机器码与普通指令对照降低了部分实现差异,但没有排除全部系统影响。
vCPU 与宿主 CPU 没有严格配对。 客户机线程固定到某个 vCPU,并不意味着对应宿主线程始终固定在某个物理执行位置。端点 TSC_AUX 相同也不能消除这一限制。
样本规模与环境覆盖是两件事。 当前记录只覆盖一套硬件、一个 PVE 内核版本和一个客户机配置。没有跨微架构、跨主机和跨系统的外部验证。
窗口内部成本没有拆分。 已知 CPUID 会经过 VMX 退出路径,但本次未对每次退出逐段追踪,不能精确分配额外时间的来源。
时间来源没有完全独立核验。 校准与接口频率提供了有用背景,仍不足以把所有计时接口视为独立证据。
更有价值的后续实验,是补充同一 Windows 在原生与虚拟化环境中的对照、多套处理器和主机、不同 hypervisor,以及实际启用 VBS 的环境。训练或选择判断规则所用的数据,还应与最终评估数据分开。
九 结论
在这组 Linux 宿主与 Windows/KVM 客户机的对照中,CPUID 测量窗口出现了明显、可重复且集中于特定路径的额外开销。
首轮五类 CPUID 窗口的客户机/宿主中位数比率为 5.93–16.06,普通对照为 1.00–1.11;完整复测保留了这种差异。Intel VMX 的退出规则和 KVM 的公开处理路径,为观察结果提供了合理的机制解释。
这说明,处理器接口除了返回内容,还具有可以测量的执行行为。CPUID 时序在本例中形成了有力证据;将这种证据用于更广泛的环境判断,需要跨平台对照、完整分布和独立验证,而不能只依赖一个固定数值。
参考资料
- Intel SDM Volume 3C,§26.1.2:正常 CPUID 在 VMX non-root 下触发 VM exit 的架构规则。
- Linux KVM VMX 处理代码固定提交快照,CPUID 退出分派及返回用户态的相关说明。用于机制解释,不代表已安装 PVE 内核逐字相同。
- Intel SDM Volume 2,RDTSCP 条目:时间戳读取、TSC_AUX 与执行顺序约束。
- Microsoft:Acquiring high-resolution time stamps,TSC、QPC、计时单位和时间来源的关系。
- Microsoft:Virtualization-based security,VBS 与 Windows hypervisor。